17 信息推测
作者把预测推广为信息推测,用输入、输出、空间和映射描述知识。核心操作是先明确推测依据、目标与适用范围,再讨论关系。
何谓思考
学习的成果,最终会体现在思考能力上。那么如何描述思考呢?
先看两个例子。
打车推测
打出租车时,我们可以查到距离、起步价、每公里计价等信息,而我们需要知道的是总价。于是,我们常会根据距离、起步价、每公里计价等信息去推测总价。
打球推测
打羽毛球时,我们可以观测到对手的动作和球的位置等信息,而大脑需要确定的是控制相应肌肉进行反击的神经信号(一种内隐信息)。于是,大脑会根据对手的动作和球的位置等信息去推测反击的神经信号。
信息推测
从这两个例子中可以发现思考的一个共性——都是从一堆信息出发,加工,得到另一堆信息。我们可以将大脑的思维过程抽象类化为一种关于信息的加工过程,如图 17-1 所示。
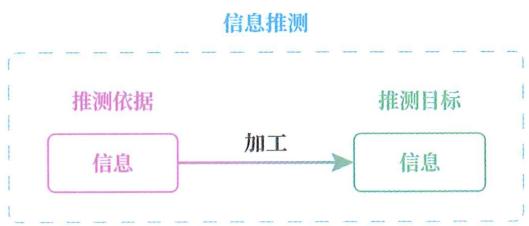
图 17-1
若仅从过程视角来看,我们会忽略信息加工前后的作用,将思维过程称为“信
息加工”或“从输入推测输出”。
但若从功能视角来看,我们则会保留信息加工前后的作用,将思维过程称为“信息推测”或“从已知推测未知”。
基于这两种视角的称呼都可以使用,但本书强调目的,因此采用“信息推测”这个名称。
预测
本书之前提到的预测实际上就是信息推测的一种特例,不同之处在于:预测是从当下推测未来,而推测的外延更广注,不仅可以从当下推测未来,还可以是(但不限于):
◎ 从当下推测过去。
○ 从后果推测前因。
◎ 从微观推测宏观。
◎ 从行为推测心理。
◎ 从局部推测全局。
基础组件
当然,人脑的思维过程并非总是上例中那样的简单情况,但不论多复杂的思维过程,都可以被拆解成若干个信息推测的组合。
做数学题
例如,做数学题的思维过程,就可以被拆解成若干个信息推测的组合,每个信息推测都涉及从输入信息到输出信息的加工。
两类推测
信息推测也可分为两种类型——经验推测和模型推测,区别为是否要运用可泛化模型来推测未见信息。
此前讲过经验预测和模型预测,只要将二者扩展一下,去掉“从当下推测未来”的限制,就可以直接扩展到经验推测和模型推测。
数学描述
对信息推测有了基础认识后,接下来,我们将运用数学概念对信息推测进行更深入的探讨。毕竟“从一堆信息推测另一堆信息”的表述,只是一种简略说法,缺失很多细节,容易让人以为自己理解了,但实际难以应用。
本体数学
在开始探讨之前,需要提醒大家避开两个误区。
首先,数学概念只是我们用来分析和描述思维过程的一个工具注,并不是说思维过程在本体上等同于数学。
之所以要提醒大家这一点,是因为生活中经常能听到诸如“X不过是数学/统计学”的言论。这其实也是类固有观的一种表现,因为说话人把“X是Y”的句式解读成了“X在物质世界中的本体是Y”。“不过是”这个用语,也反映了说话人在得知X只是数学后,感叹自己此前高估了X的本体。
两种是
实际上,汉语中的“是”有两种含义:一个是经验推测下的“是”,即等同于;另一个是模型推测下的“是”,即被归于。
◎ 当 X 和 Y 的抽象层级没有差异时,“X 是 Y”句式中的“是”意为等同于。
当 X 和 Y 的抽象层级一低一高时,“X 是 Y”句式中的“是”意为被归于,也就是将 X 归类于 Y,暗示着我们接下来将用 Y 的处理方式来处理 X。
是 \(\mathrm{H}_{2} \mathrm{O}\)
举例说明, “王阳明是王守仁” “水的化学式是 \(\mathrm{H}_{2} \mathrm{O}\) ”, 其中的 “是” 都意为等同于。
但 “苏格拉底是哲学家” 并非在说 “苏格拉底” 在本体上与哲学家这一概念等同,而是说:我们暂时剥离 “苏格拉底” 的部分属性,将其归于哲学家这个概念,并按照哲学家的统一应对法来分析和描述 “苏格拉底”。
是数学
同理,当我们用数学概念来描述思维过程时,意味着我们将按照数学概念的统一应对法来处理思维过程,并不是在宣称:思维过程在本体上等同于数学。
就是计算
第二个误区:很多人一听到数学,就会下意识地联想到复杂的公式和令人头疼的计算,认为自己不擅长数学,担心看不懂书中的内容。
其实,数学就像汉语,也是一种用来描述世界的语言。
本书内容基本不会涉及计算,你所要做的,就是渐构出一个个数学概念。只要你能像在语文课上造句那样,用这些概念来正确描述(造句)自己平时的思维过程和学习过程,就意味着你掌握了它们。
双语描述
能用来描述思维过程的数学概念有很多,为了照顾大多数读者,浆果选用人们熟悉的数学概念进行描述。
在引入数学概念时,浆果会先用日常语言来描述,随后介绍相应的数学描述。
输入输出
信息推测的日常描述是“从一堆信息推测另一堆信息”或“从已知推测未知”,若用数学语言来描述,则是“从输入到输出的单向关系”,如图 17-2 所示。
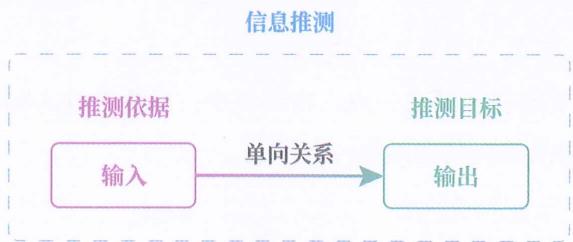
图17-2
之所以这样描述,是因为:信息推测具有方向性,而输入和输出分别意味着关系的起点和关系的终点,刚好适合表达信息推测中的推测依据(输入)和推测目标(输出)。
形式约束
输入和输出在本质上是一种“状态”,而二者的关系在本质上是一种“变化/运动”。
但要注意:这里的“状态”和“变化/运动”并不是内容上的,而是形式上的。
即使一个东西在内容上属于一种变化或动作,我们也可以不将其按照关系来处理,而按照输入和输出来处理,只需将其转换成输入和输出的形式即可。
这也意味着:一个东西能否作为输入或输出,并不是客观的,而是人主观选择的,是我们决定要如何描述。
词性形式
这就像英语中的词性。虽然游泳这个概念在内容上属于一种动作,但我们也可以不将其按照动词 “swim” 来处理,而按照名词 “swimming” 来处理,只要我们将它变成形式上的名词即可。然后,我们就可以套用 “Swimming is a popular sport” 这个名词的句式。
是否可导
再举一个实际例子。
从光的传播时间推测光的传播距离时,会得到二者的关系,姑且称其为“关系A”。此时,光的传播时间是输入,光的传播距离是输出,而关系A既不是输入,也不是输出。但是,在另一个推测中,我们其实可以把关系A视为输入去推测是否可导和是否连续。
函数输入
熟悉编程的人更容易理解这一点。在编程中,函数是输入和输出之间的关系,但函数也可以作为输入传递给另一个函数。
多输入呢
对于输入和输出的数量,一定有人会好奇:如果遇到从多个输入向多个输出的推测,该如何描述呢?
维度
其实,只要引入维度这个数学概念,就可以避免使用“多个输入”的说法。因为无论有多少个“输入”,都可以被视为一个输入的不同维度。“输出”也可以按这个逻辑处理。换句话说,我们将输入或输出看作一个多维向量而不是多个一维标量。
这样做的好处是:我们不必为不同数量的输入和输出建立不同的描述方式,可以使用统一的描述方式来应对各种数量的情况。
我们知道,任何概念都可以被拆分成多个概念,而多个概念也可以被组合为单一概念。所以,无论说“一个概念”还是“一堆概念”都没什么本质差别。但说“一个概念”会更加方便,之后可以在必要的时候,再把“一个概念”详细描述成“一堆概念”。
矢量维度
例如,从初中开始,物理就引入了矢量这一概念,也就是既有大小、又有方向的量,而大小和方向就可以被视为两个维度。就拿速度来说,其本身会被视为一个输入或输出,但其包含了两个维度——速度大小和速度方向。
打球维度
又如,在打羽毛球的例子中,我们可以将对手的动作和球的位置视为一个输入的两个维度,而不是两个独立的输入。同样地,控制肌肉的神经信号其实也有很多个,我们也可以将它们看作一个输出的不同维度。
经验推测
前面说过,信息推测可以细分为经验推测和模型推测两种类型。
当进行经验推测时,信息推测的数学描述会变得更加具体:由“从输入到输出的关系”转变为“从输入常量到输出常量的对应关系”,如图17-3所示。
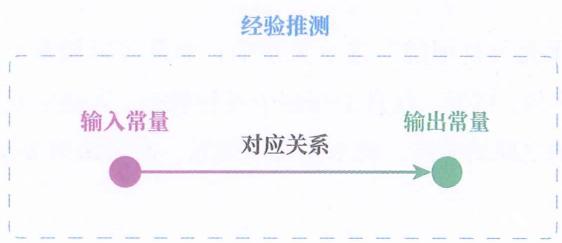
图17-3
常量
之所以用常量描述,是因为:经验推测中的输入、输出都是确定的唯一可能状态,不像模型推测中的输入、输出可以是多个可能状态中的任意一个。常量,正是用于表达这种确定的唯一可能状态的特性的。
注意,常量虽有一个“量”字,但它不必是数字,在本质上是状态。
\(3-1=2\)
举例来说, 当我们把对象层设为具体数字所处的层面时, 在 “3-1=2” 这一关系中, 3 和 1 是输入常量, 2 是输出常量, 因为 3、1、2 都是确定的唯一可能状态。
但是,在“被减数 - 减数 = 差”这一关系中,被减数和减数不是输入常量,差也不是输出常量,而是变量,因为被减数、减数、差都可以代表 1、2、1.2 等多个可能状态中的任意一个,而非确定的唯一可能状态。
对应关系
之所以用对应关系来描述,是因为在经验推测中,输入、输出的关系是两个具有唯一可能状态的对象之间的直接对应,不像在模型推测中的关系是两个可以有多个可能状态的概念之间的映射关系。
在本书中,“对应(关系)”一词专门用来指代一个常量和另一个常量之间的关系。当出现“对应”一词时,也意味着我们将当前讨论的对象视为一个常量。
这个苹果
例如,在“这个苹果是酸的”这一关系中,这个苹果是输入常量,酸的是输出常量。这个苹果和酸的之间的关系就是对应关系,因为二者被我们视为常量,都是具有唯一可能状态的对象。
但是,在“苹果是可食用的”这一关系中,苹果可以被我们视为一类事物,包含红苹果、绿苹果、国光、红富士等多个可能状态,不是常量,而是变量。此时,苹果和可食用的之间的关系,就不是对应关系,而是映射关系。
实心点
经验推测中的输入常量、输出常量、对应关系,这三者的关系就好比将一个实心点(输入常量)与另一个实心点(输出常量)用一条实线(对应关系)连上。
模型推测
同样地,当进行模型推测时,信息推测的数学描述也会更加具体:由“从输入到输出的关系”转变为“从输入变量到输出变量的映射关系”或“从输入空间到输出空间的映射关系”,如图17-4所示。
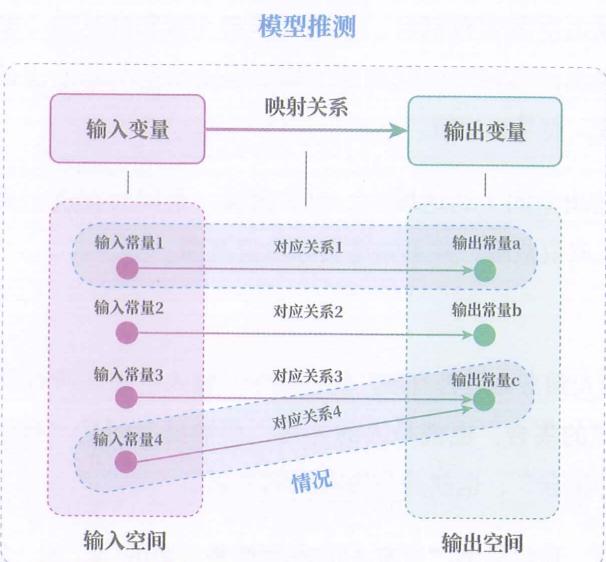
如图 17- 4
变量
之所以用变量描述, 是因为: 模型推测中的输入、输出并非确定的唯一可能状态,可以是多个可能状态中的任意一个。变量正是用于表达这种可以在特定范围内任意取值的特性的。
酸碱性
例如,“从溶液到酸碱性”的推测中,作为输入(推测依据)的溶液,并非确定的唯一可能状态,可以是温泉水、啤酒、洗衣液、氢氧化钠溶液等多个可能状态中的任意一个,因此是变量。而作为输出(推测目标)的酸碱性也不是唯一可能状态,可以是酸性、中性、碱性等多个可能状态中的任意一个,因此也是变量。
空间
我们也可以使用输入空间和输出空间来描述输入变量的可取值范围和输出变量的可取值范围。
可能一些人不熟悉空间这个数学概念,高中教过集合,而空间实际上就是满足特定性质的集合。
在这里,变量对应着自然语言中的概念,空间对应着自然语言中的概念的外延,空间里的元素则对应着自然语言中的外延里的对象。
输入空间和输出空间也有别名,分别叫作定义域和到达域(陪域)。注意与值域相区分,输出的实际取值范围是值域,但输出空间是输出的可能取值范围,因此不是值域,而是到达域。
之所以描述输出空间(到达域),而非值域,是因为在进行信息推测之前,我们只知道可能取值范围,并不知道实际取值范围。
寿命有限
例如,在“从人到寿命是否有限”的推测中,输入空间是所有具体的人(如嬴政、孔子)所组成的集合,也就是人的外延,而输出空间是“有限和无限两个可能状态所组成的集合”,也就是是否有限的外延。
尽管通过归纳,我们得出“所有人的寿命都是有限的”,即“输出的实际取值范围都是有限这一个可能状态”,但在描述这个信息推测时,我们应该说“我们在探究人与寿命是否有限的关系”,而不该说“我们在探究人与寿命有限的关系”,因为后者只不过是探究的结果。这也是为什么我们要描述“输入空间和输出空间的关系”,而不是描述“输入空间和值域的关系”。
映射关系
至于模型推测中输入(变量)和输出(变量)的关系,则选用映射关系来描述。原因在于:我们进行信息推测时,是为了做决策,需要获得确定的输出结果,而非“既是又是”的输出结果,因此,输入变量在输入空间内的每一个可选取值,都只能对应唯一一个输出取值,不可以对应两个以上的输出取值,否则会得出矛盾的结论。而映射关系就是具有这种约束的变量间的关系,即:输入变量在输入空间的每一个可选取值,都只能对应一个唯一的输出取值。
及格映射
例如,“从大学期末分数到是否及格”的推测中,输入空间是0至100的有理数所构成的集合,输出空间是“及格”和“不及格”两个元素所构成的集合。输入变量在0至100范围内的每一个取值,都只能对应一个唯一的输出取值,要么输出 “及格”,要么输出 “不及格”,如果既对应 “及格” 又对应 “不及格”,就相当于没推测。
通常,大学的判定规则都是:当输入为0至59时,都对应不及格,而输入为60至100时,都对应及格,因此这是一个映射关系。若150分为满分,那么输入为0至89时,都对应不及格,输入为90至150时,都对应及格,这又是另一个映射关系。
有什么用
当我们渐构好输入 / 输出、常量、变量、维度、空间、对应关系、映射关系这些数学概念后,还可以用它们来更精确地描述思维过程、经验和知识。
思维过程
思维过程可以被描述为从输入到输出的推测(加工)过程。
输入是思维过程的起点,也是推测的依据。
输出是思维过程的终点,也是推测的目标。
描述经验
事件 / 情况可以被描述为 “从一个输入常量到一个输出常量的对应关系”。
这样一来,我们就能用数学语言来描述经验了,也就是已见情况。
描述知识
至于知识,之前我们只能粗略地将其描述为“从一类事物到另一类事物的通用关系”或“多个情况之间的共有关系”,但这些描述仍不能清晰地说明知识的适用范围和作用。
现在,我们有了更好的描述方式。
在一个信息推测(任务)中,我们通常依靠记忆和回忆已见情况(经验),来根据输入推测输出,也就是进行经验推测。我们也可以渐构成一些通用规律。如果某个通用规律不仅能用于推测已见情况(经验)的输入该对应什么输出,还能用于推测广泛的未见情况的输入该对应什么输出,那么这个通用规律就是
基于该信息推测的一个知识。
这里有几个要点:
☐ 知识总是属于某个信息推测(任务)的,但对于同一个信息推测,可以渐构成多个不同知识。
◎ 知识不能仅适用于一种情况,必须能用于推测多种情况,同时包括未见情况。
◎ 知识的映射关系必须符合实际情况。
若用数学语言描述:
◎ 知识是在一个信息推测中对所有输入变量的取值都能推测出正确的对应输出的映射。
◎ 知识的适用范围就是其输入变量的取值范围,也就是它的输入空间。
◎ 知识的作用是帮助我们推测未见情况。
需要注意的是:在描述一个知识时,不能只说它的映射关系,必须说明这个映射关系是“从哪个变量到哪个变量的映射关系”。换句话说,需要输入空间、输出空间、映射关系三个要素注,才能完整描述一个知识。
惯性定律
举例来说,牛顿第一定律(惯性定律)是一个知识,属于“从受外力为零的物体到物体的加速度的推测规律”。
☐ 知识的输入空间是所有受外力为零的物体组成的集合,元素可以是在桌面上受重力和桌面支持力作用的苹果或不受摩擦阻力作用的滚动的小球等。
☐ 知识的输出空间是所有物体的加速度组成的集合,元素可以是 \(-2 \, m/s^{2}\) 、9.8 \(m/s^{2}\) 或静止等。
◎ 知识的映射关系是 “所有受外力为零的物体都对应加速度为零(静止或匀速直线运动)”。
☐ 知识的适用范围是所有受外力为零的物体组成的集合。如果某对象不属于物体,则不适用;如果不是受外力为零的物体,也不适用。
浮力定律
又如,阿基米德定律(浮力定律)是一个知识,属于“从浸入液体的物体到物
体受到的浮力的推测规律”。
◎ 知识的输入空间是所有浸入液体的物体所构成的集合,元素可以是部分浸入水中的木块或完全浸入油中的铁球等。
◎ 知识的输入可以分成两个维度,即浸入液体的体积和液体的密度。
◎ 知识的输出空间是所有物体受到的浮力的集合。
◎ 知识的映射关系是 \(F=\rho_{液}V_{排}g\) 。
◎ 知识的适用范围是所有浸入液体的物体所构成的集合。
对照表
表 17-1 展示了自然语言和数学语言的概念对照。
表 17-1 自然语言和数学语言的概念对照表
| 自然语言 | 数学语言 |
| 信息推测 / 思维过程 / 认知过程 | 从输入到输出的关系 |
| 对象 / 现象(推测依据) | 输入常量(输入空间的元素) |
| 对象 / 现象(推测目标) | 输出常量(输出空间的元素) |
| 仅对单一情况有效的关系 | 对应关系 |
| 一个对象和另一个对象的个别关系(情况) | 从输入常量到输出常量的对应关系(有序对) |
| 概念(推测依据) | 输入变量 |
| 概念(推测目标) | 输出变量 |
| 推测依据的概念外延 | 输入空间 |
| 推测目标的概念外延 | 输出空间 |
| 对一类情况有效的通用关系 | 映射关系 |
| 一个概念和另一个概念的通用关系(知识) | 从输入空间到输出空间的映射关系(可泛化模型) |
| 知识的适用范围 | 映射的输入空间 |
| 可拆分成多个概念的概念 | 多维向量 |
明确入出
可以发现,知识的输入空间表达了知识的适用范围注,而知识的输出空间表达了预测目标——能让我们明白该知识可以告诉我们什么信息。
如果一个人在学习某个知识时,不清楚这个知识的输入空间,他就不知道该知识在什么情况下有效、什么情况下无效。如果不清楚知识的输出空间,他就无法判断何时能用上该知识。
因此,我们可以得到学习的第一原则:学习任何知识时,都要先明确该知识的输入空间和输出空间,简称“明确输入输出”。
如何明确
不过,要依靠什么明确输入输出呢?
主干提要
- 思维过程可抽象类化成信息推测过程。
- 复杂的思维过程可拆解为若干信息推测的组合。
- 信息推测分为经验推测和模型推测。
- 思维过程并非本体上是数学,而是可由数学语言所描述。
- “是”有等同于和被归于两种含义。
- 推测依据和推测目标可用输入和输出描述。
- 输入和输出是形式上的,而非内容上的。
- 任何数量的信息都可以被一个多维输入和一个多维输出所描述。
- 经验推测和模型推测在数学语言下有了更准确的描述。
- 经验和知识在数学语言下也有了更准确的描述。
- 学习任何知识,都需要先明确知识的推测依据(输入)和推测目标(输出)。
概念提要
信息推测:从一堆信息到另一堆信息的推测。
◎ 输入:推测依据。
◎ 输出:推测目标。
◎ 维度:描述一个状态时所需的独立参数。
◎ 常量:确定的唯一可能状态。
◎ 经验推测:基于输入常量到输出常量的对应关系所实施的推测。
◎ 对应关系:一个常量和另一个常量之间的对应。
◎ 模型推测:基于输入变量到输出变量的映射关系所实施的推测。
○ 变量:可在特定范围内任意取值的状态。
◎ 空间:变量可取值的范围。
◎ 映射关系:输入变量到输出变量的一种关系(条件是:输入空间的每个取值有且仅有一个对应的输出变量)。
◎ 思维过程:从输入到输出的推测。
◎ 经验:(反映现实的)输入常量到输出常量的对应。
◎ 知识:(反映现实的)输入变量到输出变量的映射关系。