08 自主优劣
熟练能节约意识投入,也会让归类依据变得不自觉。作者提出回撤再归类和组块化,但强调这些能力有前提与训练代价。
自主化
能否从意识处理转成自主处理,取决于任务的性质。注有些任务不行,但许多都可以。
为了方便指代,我们把大脑对某个任务的执行,从只能靠意识处理,变成可以自主处理的转换过程称为“自主化”或“内隐化”。
像 [th] 的听力感知这样的任务,本身就无法依靠意识处理来做到,自然也就谈不上从意识处理到自主处理的自主化了。
一些复合性很强的任务,依赖于多个模型和外部记忆的综合调用,必须依靠意识处理,同样也谈不上自主化。
还有一些任务, 当我们第一次去执行的时候, 脑中并没有针对该任务的内隐模型, 只能依靠意识对多个模型和外部记忆的综合调用来实现。但每次执行后, 脑中会留下相应的内隐记忆。随着大脑对这些内隐记忆的积累和加工, 针对该任务的内隐模型就被渐构出来了, 之后便可用这个内隐模型来直接自主处理该任务, 也就实现了自主化的转变, 如图 8-1 所示。
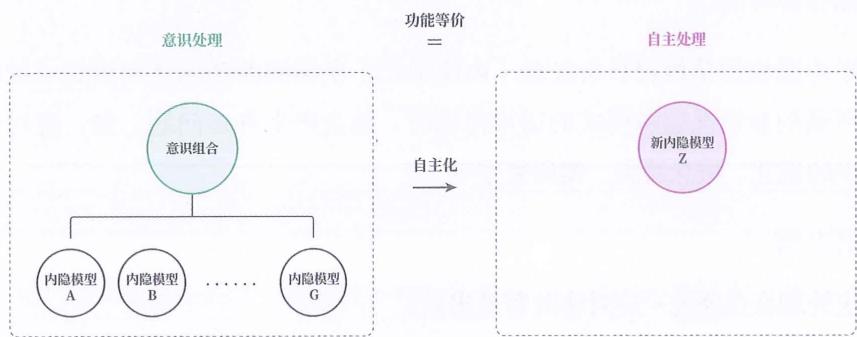
图8-1
打字
例如,当我们第一次学习键盘打字时,脑中并没有键盘打字的内隐模型,我们只能通过有意识地将确定字母、寻找键位、判断手指、单次敲击这几个步骤组合在一起,来实现键盘打字。但随着不断实操,大脑会慢慢根据所积累的内隐记忆渐构成键盘打字的内隐模型,也就实现了键盘打字的自主化。
培养乐手
如果把新任务类比成新乐器,把大脑类比成乐队,那么自主化就好比:乐队培养了一个专门演奏新乐器的乐手,以后可以交由乐队指挥(类比意识)直接调遣。
自主优劣
那自主化了之后,会有什么好处,又有什么坏处呢?
多少钱
现在请你以最快速度回答下面的问题:
“笔记本与铅笔加来起共 11 元,笔记本比铅笔贵 10 元,铅笔少多钱?”
很多人会回答 1 元,也就是用 11 元减去 10 元。但铅笔应该是 0.5 元,而笔记本应该为 10.5 元,只有这样才会相差 10 元。
可能你有所防备,答对了。但请你再读一遍问题,会发现其实句子中的“起”和“来”字,“少”与“多”字的顺序颠倒了。
几大缺点
从这个例子可以看出,虽然自主处理能让我们轻松快捷地处理任务,但自主处理也容易出错。
由于内隐模型是根据日常经验(内隐记忆)所渐构的局部适用模式(规律),当所遇的新情况超越模式的适用范围时,就会产生许多问题,如:应对误判、知识的诅咒、概念遮蔽、编码繁重等。
应对误判
自主处理在选择统一应对法时容易出错。
当遇到非典型问题时,自主处理会很容易因为该问题的某个侧面碰巧符合某个
内隐模型,而将问题判别到错误的概念体系下,以错误的方法去应对。
减法误判
上面的“铅笔多少钱”就是很好的例子。这并不是因为我们不够聪明,而是当我们被要求快速执行某任务时,大脑往往会因为时间紧迫,跳过意识,直接做自主处理,于是就用基于平时经验所建立的内隐判别模型,把问题判别成了典型减法来解决。
扔垃圾
又如,一个人一手拿着手机,一手拿着饮料,跟朋友聊得正起劲时,结果把手机当喝完饮料的空杯子扔了。
吃墨
还有 “王羲之吃墨” 的故事,由于王羲之的意识被写字任务占用了,误把墨汁当成了蒜泥蘸着吃了。
魔术引导
魔术可以说就是专门运用“应对误判”的一门艺术。魔术师在表演时,会通过各种手段引导观众的大脑产生误判。比如,有意制造一些符合日常经验但实际“反模式”的特殊情况。
知识诅咒
自主处理还容易产生“知识的诅咒”。
当我们首次学习某个新概念时,可以清楚地认识到自己是怎么将某现象判别成特定概念的。但当这个判别过程在我们的脑中自主化后,我们就会无意识地运用这个概念来编码和解释周围的现象,甚至将编码结果视为了现象本身。
于是,我们开始回不到原来的现象层面,很难理解别人为什么和自己不在一个层面上,也很难理解初学者为什么不懂,意识不到自己其实已经运用了一种知识,也就是那个概念的内隐判别模型,而别人脑中未必有这个模型,或者对所讨论的现象用其他概念进行了编码。
当我们尝试指导他人时,由于没有意识到某种知识的存在,也就不会把对方的不理解归因于自己漏讲了某种知识注,而认为是其他原因所致。
辅导数学
家长辅导孩子学习时,就会出现大量“知识的诅咒”。
想象一下, 一位家长正辅导孩子如何用加减消元法来解方程组, 指着试卷大声说: “来, 先读题。
“笔记本与铅笔加起来共11元,笔记本比铅笔贵10元,铅笔多少钱?”
“我们设笔记本为 \(x\) 元,铅笔为 \(y\) 元。
“由题可知, \(x + y = 11\) ,x - y = 10。
“用第一个方程减去第二个方程,得到 \(2y = 1\) ,进而求得 \(y = 0.5\) 。
可家长每次讲完一道题,让孩子做新题时,孩子就是做不出来。这使家长愈发不耐烦。因为家长认为,这么简单的加减消元法,孩子不可能学不会,肯定是不认真、没用心。
但真实情况是:孩子不懂的并非加减消元法的步骤,而是不理解什么现象可以被判别为未知数、什么现象可以被判别为方程,也就是缺少未知数和方程的判别模型。
这些基础数学概念的判别对于熟悉相关内容的家长来说已经内隐化、自主化了,家长很难意识到,导致孩子做不出加减消元法题目的真正原因是孩子无法从题中找出能被判别为未知数和方程的现象。
概念遮蔽
自主处理还容易导致概念遮蔽:一些不该被剔除细节的现象,也被我们归类成了特定概念,从而遮蔽了该现象的某些关键信息。
老板指责
我们都有过这样的经历: 吵架的时候词穷语塞, 事后才反应过来其实能完美反驳。
比方说,一位员工索要加班费,被老板指责:“只顾个人利益,丝毫不肯奉献,不为公司着想。以后公司有什么福利,你觉得还有可能分到你吗?”该员工想回应,却一时语塞,后来才反应过来哪里不对。
这其实就是自主编码所带来的遮蔽。在当时对峙的状态下,员工的大脑无意识地顺着老板提供的概念来编码,并直接在老板所归类的层面上——也就是“自私”的层面上——思考怎么反驳,但“自私不好”这个命题本身是没问题的,所以员工当时语塞。
可问题出在编码之前,那个被归为“自私”的现象原本是什么,以及这种概念编码是否合理。这些都在大脑的自主处理中被暂时遮蔽了,员工的思维完全陷到了“自私不好”的命题网络中,跳不出来了。
母语遮蔽
我们学习外语时存在一个有趣现象,也是自主编码带来的遮蔽所导致的。
那就是,成年人初学外语时,总是觉得词汇量不够,想表达的概念不知道用外语怎么说。但实际上,他完全有能力表达,只是他的大脑总是用平时习惯的母语概念进行自主编码,导致意识不到自己只要用层次较低的概念就能表达类似的意思。
比如,某英语初学者想要表达“他具有勤俭节约的优秀品质”,结果不会说“勤俭节约”的英语单词。其实,说“He doesn't waste anything”或“He is good at saving money”就能表达相近的意思了。
回撤转码
那么,要怎么避免自主编码所带来的遮蔽问题呢?
一种办法就是将归类后的概念还原到归类前的现象,恢复那些被抽象掉的特殊属性,如图 8-2 所示。
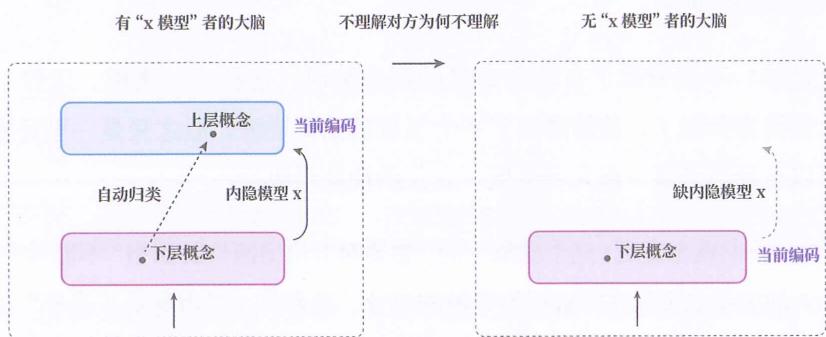
图8-2
我们称该过程为“现象还原”或“编码回撤”。
接着,为还原后的现象重新选择一个更合理的概念编码。我们称其为“重新归类”或“编码转换”,如图8-3所示。
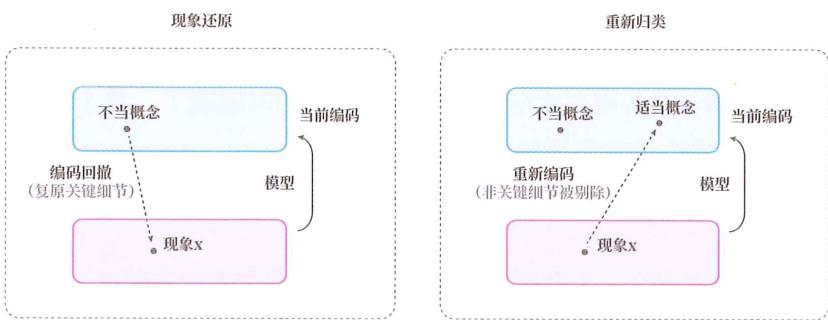
图8-3
通常,现象还原和重新归类是配合使用的,但也可以选择不再归类,而是直接在还原后的现象层面进行处理。
需要明确的是:“现象还原”并非还原到物质现象的层面,而是回到归类前的抽象层级,可能结果不完全相同,但能够尽量去逼近。因此,将现象还原理解为降低抽象层级更为准确。注
关系回撤
拿“员工被指责”的例子来说,不要在老板所判别的自私和奉献的抽象层面上思考如何反驳,而是先思考原始现象是什么?
思考结果可以是:一个人拿出一部分时间给另一个人做事情,以换取金钱或其他形式的回报。某天,该人被要求额外拿出一部分时间来做事情,而他想要对方给出额外的回报。
这个还原,不仅回撤了自私和奉献的概念编码,连员工、老板、工作、薪水的概念编码都回撤了,整体降到了一个很低的抽象层级。但这只是一种还原方式,还可以选择稍微高一点儿或更低一点儿的抽象层级。
还原后, 我们就会发现, 这个现象中的 “想要对方给出额外的回报” 不能被归为自私, 两个人的关系也不存在可被归为奉献的成分, 反而是 “老板称员工自私” 的行为是老板用来遮蔽 “自己想要员工额外干活, 但不打算给额外回报” 的说辞。
我们可以选择就在这个抽象层级上进行认识,也可以选择重新归类,将双方关系归为交换或交易。重新归类后,我们能更加清楚地意识到,交换行为根本不存在自私和奉献一说,甚至可以反过来把“老板要求员工额外工作,但不给相应报酬”的行为归为剥削。
资本论
至此,不得不提卡尔·马克思这位“还原再归类”大师。
马克思在《资本论》中,对薪水、雇佣、资本、劳动等概念统统做了现象还原,将资本主义被政治经济学概念所遮蔽的“不公”和“自我悖论”,全都揭示了出来。因此《资本论》的副书名为“政治经济学批判”,该书是对政治经济学的概念归类的批判。
渐构回撤
其实浆果对学习也采用了还原再归类,将社会视角下的“学习”还原到了现象层面,以揭示被社会视角所遮蔽的属性。
观看字符
请观看图8-4中的内容10秒钟。
43DC65FE87HG
图8-4
由于没有提前告知需记忆图中这串字符,你对它的编码应该是一种无意识干预的自主编码。此时,你可能会像大多数人一样,只能回想起几个字符。
现在,请再次观察图 8-4 中的字符,并有意识地进行记忆。此时,你可能会采取多种不同的编码方式,例如:
◎ 将每两个字符视为一组,记忆成 43-DC-65-FE-87-HG。
◎ 将每四个字符视为一组,记忆成 43DC-65FE-87HG。
◎ 将数字和字母分开,记忆成 436587-DCFEHG,然后交叉排序。
◎ 用数字按顺序代表26个字母,仅记忆436587,再根据各数字确定对应字母。
◎ 在上一种编码的基础上,把 436587 看作 345678,再每两个数调换一次顺序。
你会发现,同样是记忆 43DC65FE87HG,但采用不同的编码方式,会产生不一样的记忆效果,甚至会造成能记住和记不住的巨大差异。也就是说:我们的记忆能力并不是固定不变的,取决于我们对现象的编码方式。
编码繁重
为什么会产生上面的现象?
我们知道,大脑可以同时保留在意识上的信息量是非常有限的,通常为约4个记忆单元。这也是为什么我们在报电话号码时,会将其分成每组3~4个数字。
但大脑的记忆单元不是数字、字母或汉字,而是概念,只不过一个概念可以代表任何现象,比如一个数字、一对字母或一个故事。不同的编码方式意味着大脑会将所需记忆的内容拆分成不同数量的概念来记忆。就像把一堆水果装进若干个箱子中来保存,根据选用的箱子大小,拆分出的箱子数量就会不一样。当我们的大脑对一个现象采用自主编码时,就可能因为拆分出的概念数量超过工作记忆容量,导致记不住。
我们把不佳的自主编码导致过多的记忆单元被浪费的现象简称为“编码繁重”。
组块化
面对编码繁重现象,我们可以有意识地去优化编码方式,减少编码所需的概念数量,使其能够被大脑的工作记忆同时容纳。而这也意味着,我们要将原本靠多个概念所编码的部分仅用一个概念来编码,这种编码优化也被称为“组块化”。
字符串
例如,在刚才记忆那串字符时,我们就将“一个概念编码为一个字符”改成了“一个概念编码为两个字符”,甚至改成了“一个概念编码为六个字符”。
一箱多装
前面曾把所要记忆的现象比作水果,把概念比作箱子,而组块化就相当于把一个箱子装一个水果改成一个箱子装多个水果,从而减少箱子总数。
组块代价
如果你现在上网搜索“组块化”,会发现“组块化”被描绘成了“记忆的神器”。
浆果有必要对这种普遍存在的夸大进行澄清。
组块化现象是真实存在的,但仅仅知道组块化这个概念,以及组块化能帮助优化工作记忆容量这一现象,并不能提升你的记忆力。
原因在于,组块化的运用是有条件的。注你必须先经过大量的训练,渐构出对应概念的判别模型,才能用这个概念来编码。这就像,你必须先造出能装多个水果的箱子,才能用一个箱子装多个水果。
然而,一个概念所需整合的内容越多,建立相应判别模型所需的训练量也就越大。这一规律表明,组块化本身并不是提升记忆力的万能钥匙。想象一下,最大的组块化就是将所要记忆的现象直接编码为一个概念,但这种方式所需的训练量过大,以至于我们实际上并无法运用这种编码方式。
一生
组块化现象并不神秘,因为我们从小到大一直在不知不觉中进行着组块化。
初学汉语时,我们用一个个偏旁部首来编码汉字。
后来,我们开始将多个偏旁部首视作一个整体,以此来编码汉字。
再后来,我们甚至能将多个汉字视作一个整体,来编码词汇、短语,乃至整句话。
但多数人的组块化也就停留在了编码短语和零星的句子,不是因为不懂组块化的好处,而是段落组块的通用性很差,为了能兼顾到无数个不同段落,所需的训练量已经超出了普通人的承受范围。
专业化
很多人所讨厌的专业概念,其实就是组块化的应用。
组块化不是被描述成了“记忆的神器”了吗?为什么还被很多人讨厌呢?因为人们接受不了组块化的代价。
组块启示
实际上,组块化最直接的作用是:它让我们明白,通过有意识地编码,有时可以优化自主编码过程中出现的编码单元数量超过工作记忆容量的问题。
这就好比让我们明白,当相机的自动对焦功能无法准确对焦时,转用手动对焦是一个有效办法。
至于提升记忆力,其实组块化给我们的最终指导是:要想提高记忆力,就需要通过努力训练,渐构出更多的判别模型,丰富自己脑中的概念世界。
凭何而造
可见,不论是组块化,还是前面所说的还原再归类,都回归到了对概念世界的渐构。
既然概念如此重要,必然有人要追问:概念难道是我们想造就能造的吗?要以什么为依据,来判断一个新造的概念是否科学?
主干提要
- 有些任务可从仅能意识处理转变为可以自主处理。
- 自主处理虽快,但有应对误判、知识的诅咒、概念遮蔽、编码繁重等缺点。
- 可通过有意识地进行现象还原 + 重新编码,克服自主编码导致的概念遮蔽。
- 可通过组块化克服编码繁重问题,降低工作记忆所需的容量。
- 运用组块化要先渐构对应的判别模型,概念整合涉及的内容越多,渐构的代价越大。
概念提要
◎ 自主化 / 内隐化:从仅能意识处理到可以自主处理的转变。
◎ 知识的诅咒:因内隐化而意识不到自己的编码有异于他人的编码。
◎ 现象还原 / 编码回撤:将编码后的概念还原到编码前的原现象。
◎ 重新归类 / 编码转换:对还原后的现象重新进行编码。
☐ 组块化:通过有意识地优化编码方式,减少编码所需的概念数量,降低工作记忆所需的容量。